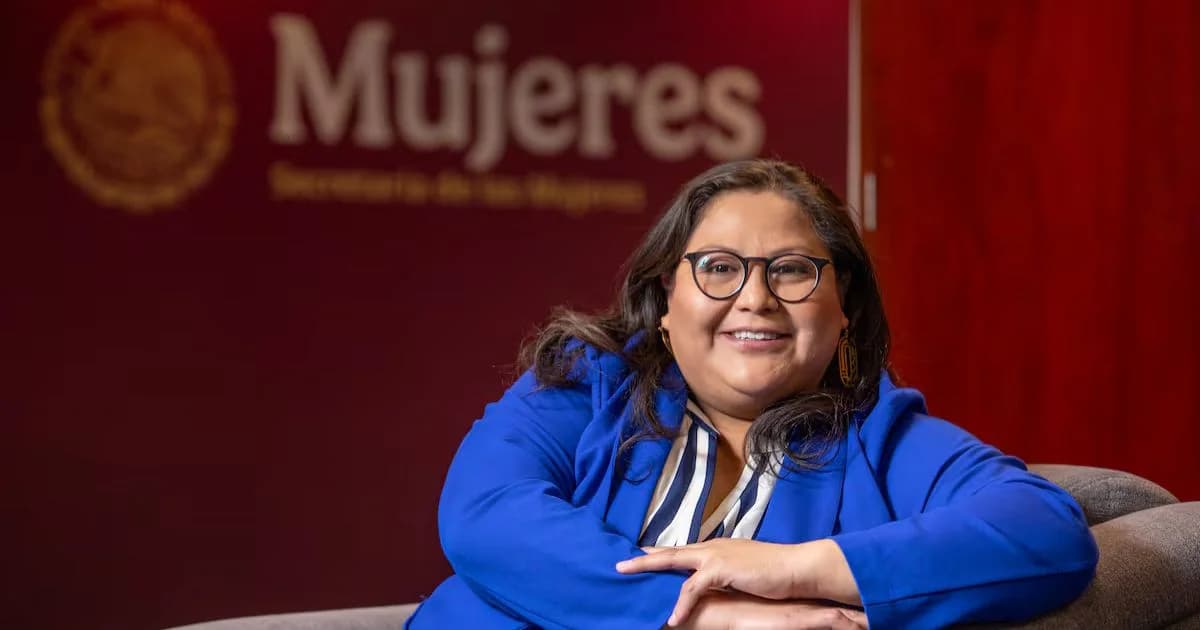
Citlalli Hernández suma apoyos rumbo a Cuauhtémoc
Citlalli Hernández suma respaldos dentro de Morena rumbo a Cuauhtémoc, aunque aún no confirma una candidatura y el partido no ha emitido la convocatoria.
Claude y OpenAI quedaron vinculados en una prueba de Hacktron AI: investigadores usaron el modelo de Anthropic para detectar dos fallas de seguridad.
Claude y OpenAI quedaron vinculados en una investigación de ciberseguridad realizada por Hacktron AI. Un equipo de tres investigadores utilizó modelos de Anthropic para desarrollar parte de una cadena de explotación que combinó una vulnerabilidad en el procesamiento de imágenes del foro comunitario alojado en Discourse con un problema de autenticación relacionado con OpenAI. El ejercicio permitió tomar control de cuentas de ChatGPT y Codex de empleados y demostrar acceso al repositorio interno mediante una solicitud de cambio inocua, sin continuar hacia información sensible. Los hallazgos fueron reportados a las empresas involucradas; OpenAI corrigió su falla y entregó una recompensa de 6 mil 500 dólares.
El equipo de Hacktron AI estuvo integrado por tres investigadores. De acuerdo con su reporte retomado por medios especializados, el proceso completo, desde el análisis inicial hasta demostrar acceso al repositorio interno, tomó menos de 72 horas.
El caso no corresponde a una intrusión criminal atribuida a Claude. Los investigadores humanos dirigieron las pruebas y utilizaron modelos de Anthropic como herramientas para analizar y desarrollar parte del exploit. Posteriormente comunicaron los hallazgos a OpenAI y Discourse.
La investigación comenzó con una falla en el procesamiento de imágenes del foro comunitario de OpenAI, que opera sobre Discourse. El equipo trabajó primero con Claude Opus 4.8, pero ese modelo no consiguió producir un exploit funcional para la configuración que estaban analizando.
Tras la disponibilidad de Claude Opus 5, los investigadores volvieron a plantear el problema y, según el reporte de Hacktron, el modelo logró generar código que permitió explotar la vulnerabilidad de ejecución remota.
El acceso al servidor del foro no fue el final de la cadena. Los investigadores identificaron además un problema relacionado con el sistema de inicio de sesión que permitió tomar control de cuentas de ChatGPT y Codex de empleados de OpenAI.
Una de esas cuentas tenía Codex conectado a la organización de OpenAI en GitHub. Para demostrar el alcance sin revisar código interno sensible, el equipo indicó a Codex que abriera una solicitud de cambio —un pull request— en el repositorio interno y después detuvo las pruebas.
OpenAI señaló que los problemas identificados fueron corregidos. De acuerdo con la información publicada sobre el caso, la compañía restringió permisos asociados con los tokens de inicio de sesión del foro comunitario y revocó tokens y sesiones afectados.
La empresa entregó a Hacktron AI una recompensa de 6 mil 500 dólares. OpenAI aclaró que las pruebas contra el foro alojado por Discourse estaban fuera del alcance de su programa de recompensas y que el pago correspondió al hallazgo relacionado con sus propios sistemas.
La relación entre Claude y OpenAI en este episodio ilustra cómo los modelos avanzados pueden acelerar tareas que antes requerían más tiempo y recursos especializados. En este caso, la capacidad se utilizó dentro de una investigación que terminó con la notificación y corrección de las vulnerabilidades.
El mismo avance plantea un reto para la industria: conforme los modelos adquieren mayores capacidades para analizar código y construir herramientas, los mecanismos de detección, evaluación y respuesta de seguridad también necesitan evolucionar.
Citlalli Hernández suma respaldos dentro de Morena rumbo a Cuauhtémoc, aunque aún no confirma una candidatura y el partido no ha emitido la convocatoria.
Agua para León es un compromiso federal: Sheinbaum dijo que se garantizará el abasto y que se buscarán acuerdos para definir la alternativa.
Los trenes en Guanajuato forman parte de corredores hacia Guadalajara y Nuevo Laredo; el tramo Querétaro-Irapuato tendrá estaciones en la entidad.